AI探索指南

  1. 为了无限制的体验Google新上的图片模型Nano Banana Pro,开了Ultra会员玩了好几天,只能说确实太强啦⋯⋯

    为了无限制的体验Google新上的图片模型Nano Banana Pro,开了Ultra会员玩了好几天,只能说确实太强啦⋯⋯

    看了一下历史记录,已经生成了有1000+图片数量了,有点上瘾的,我慢慢更新分享一些作品和经验吧。

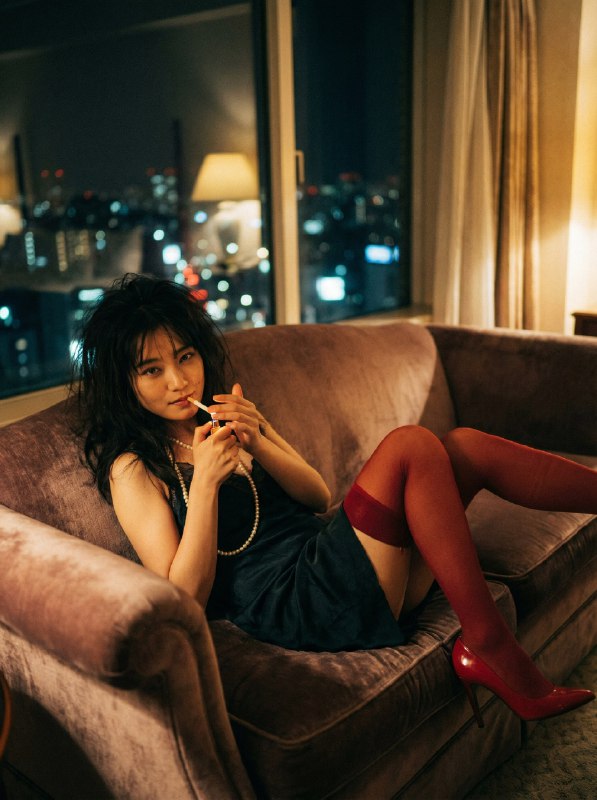
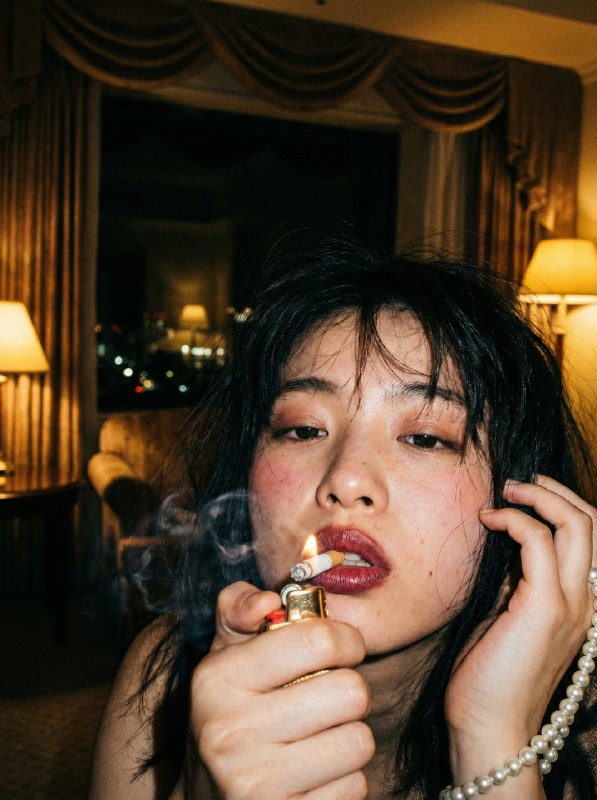
    首先还是谈谈拟真性,Nano Banana Pro的风格模仿(抄袭)能力吧,基本上可以实现指谁抄谁,不需要喂太多素材,只需要给它几张目标图片加上文本指令,就能非常灵敏的依葫芦画瓢,形成融合后的二创作品。

    比如第一组的3张图,让它学习荒木经惟和王家卫的风格,融出一种散漫迷离的地下杂志印刷品,从左到右的指令详细度递减,也就是给模型发挥的自由度越宽松。

    比如图1的提示词:一张高质量的照片,照片中的女子是一位极其美丽的18岁女孩,风格类似荒木经惟和王家卫的组合,品质上乘,堪称杰作,官方艺术作品,夜晚,单人,肌肤纹理自然,眼睛和面部细节逼真,丰满的嘴唇,腮红,口红,微张的嘴唇,长发,美腿,高挑纤细,纤细修长的双腿,模特,(黑色过膝长袜:1.2),(黑色高跟鞋:1.3),正面照,她斜倚在豪华酒店套房的天鹅绒沙发上,透过窗户可以看到城市灯光,电影般的灯光效果,她眼神冷漠地看着观众,正在阅读《花花公子》杂志,氛围优雅。

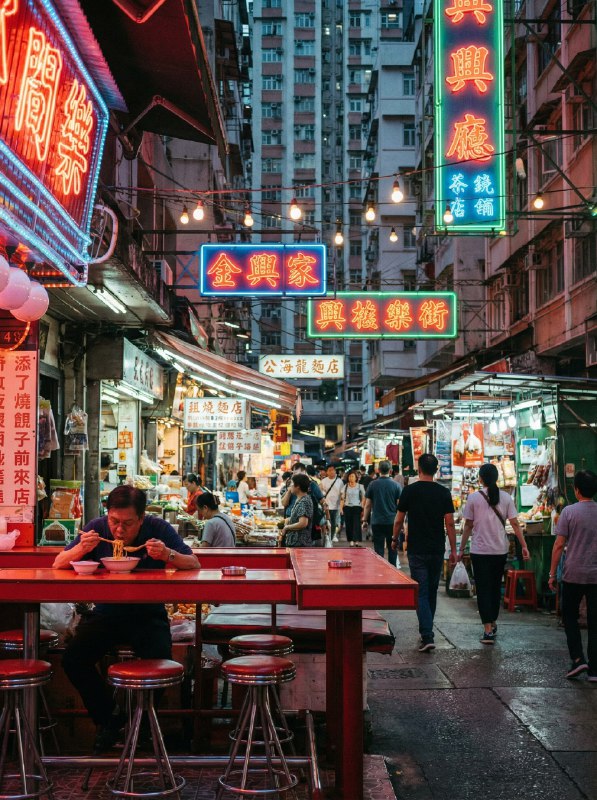
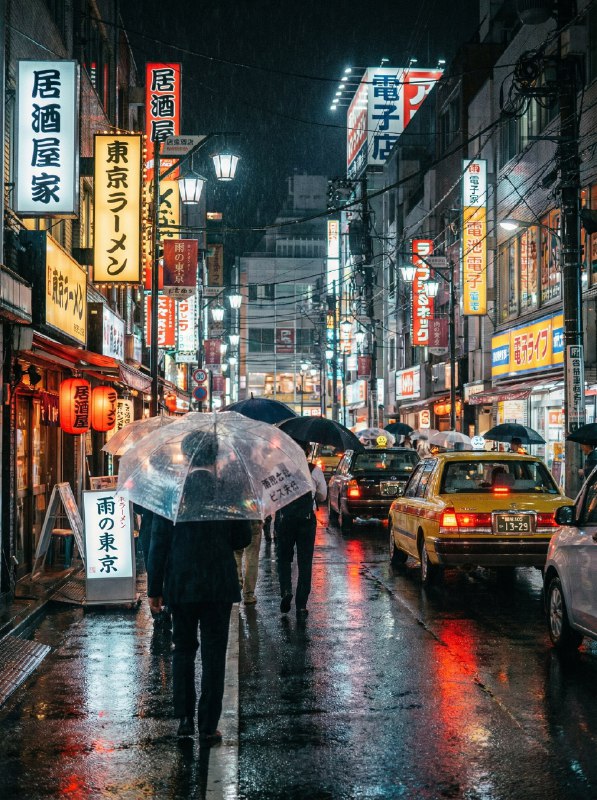
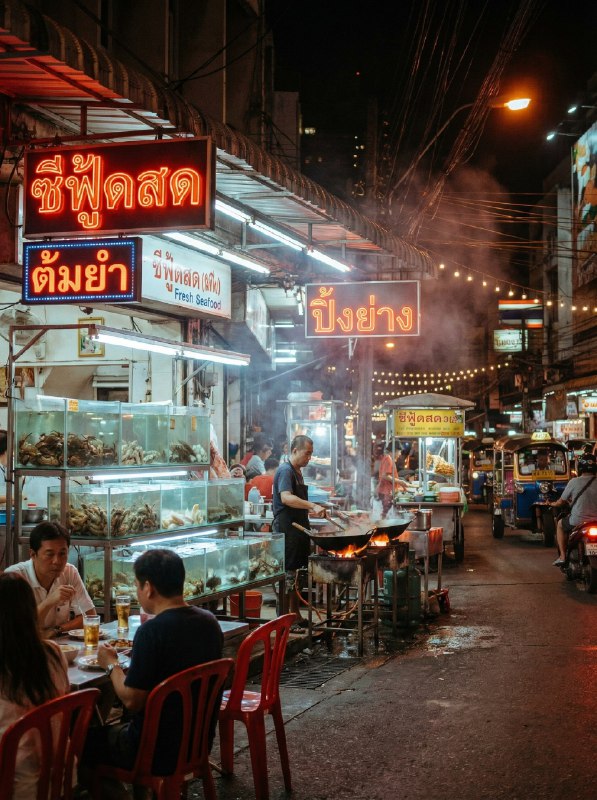
    然后第二组的3张图,我是直接在Google上随便截取了几张夜晚街景的摄影作品,然后让Nano Banana Pro基于同类风格生成香港、东京、曼谷的Street Photography,没抽卡,直接出,除了文字细节之外,已经看不到太多瑕疵了。

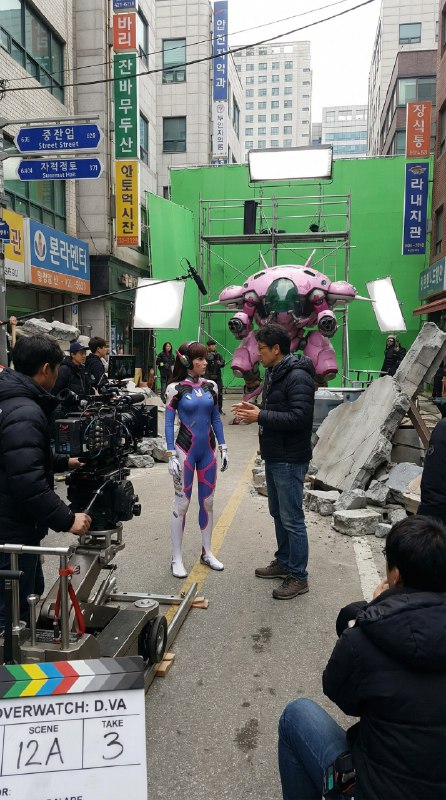
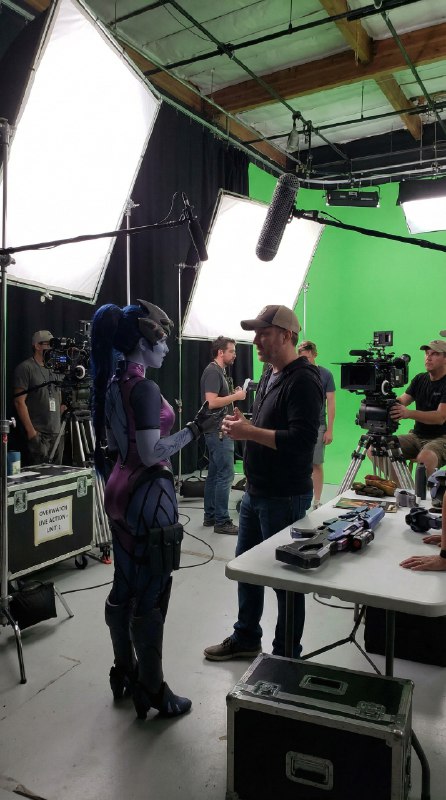
    最后是第三组的3张图,我让模型参考这段时间很火的AI视频「动漫作品真人化的现场花絮」,帮我生成守望先锋的同题图片以便于我去转成视频,于是也一步到位的拿到手了。

    提示词很简单:《守望先锋》的真人电影幕后花絮,DVA的外景拍摄,首尔街头。(如果环境提示词多写点,可以把场景控制得更符合常理,我懒得写。)

  2. 在一个对话里,和 AI 多轮问答后,最终得到满意的回答,此时,不要停步于此,再追问一句,“如果你一步到位生成最终的回答,我给你的提示词应该怎么写?给出详细、精准的提示词,附理由

    在一个对话里,和 AI 多轮问答后,最终得到满意的回答,此时,不要停步于此,再追问一句,“如果你一步到位生成最终的回答,我给你的提示词应该怎么写?给出详细、精准的提示词,附理由。”提示词就像桥梁,上承提问者的问题,下启 AI 的回答。攒一些自己常用的提示词,可以让你手里的 AI 发挥更大的价值,尤其是对于高频的问题,一类问题有一个对应的提示词。在后续与 AI 对话过程中,慢慢迭代提示词,以求更精准得到满意的答案。

  3. 周末忙炸了,用户激增,没有休息

    周末忙炸了,用户激增,没有休息。
    我们发现用户做完AI播客都是配图发视频号…
    于是干脆做了一个自动配图功能,直接生成解说视频了

    https://mp.weixin.qq.com/s/BRzC1wazYIGkPKn_y__ryw

    视频的默认风格就很好看,而且很有信息量,特别适合把文章转成视频
    还支持所有的自定义风格,比如小黄人、rick and morty、原神、经济学人,你能想到的都可以
    还支持参考图,你可以把自己放到视频里
    内测用户说,这功能真是自媒体的福音啊
    那可不是,ListenHub,就是自媒体的福“音”
    哈哈哈

    https://mp.weixin.qq.com/s/BRzC1wazYIGkPKn_y__ryw

  4. 搞了个牛皮东西,Nano Banana Pro 帮你生成任意位置的打卡照!

    搞了个牛皮东西,Nano Banana Pro 帮你生成任意位置的打卡照!

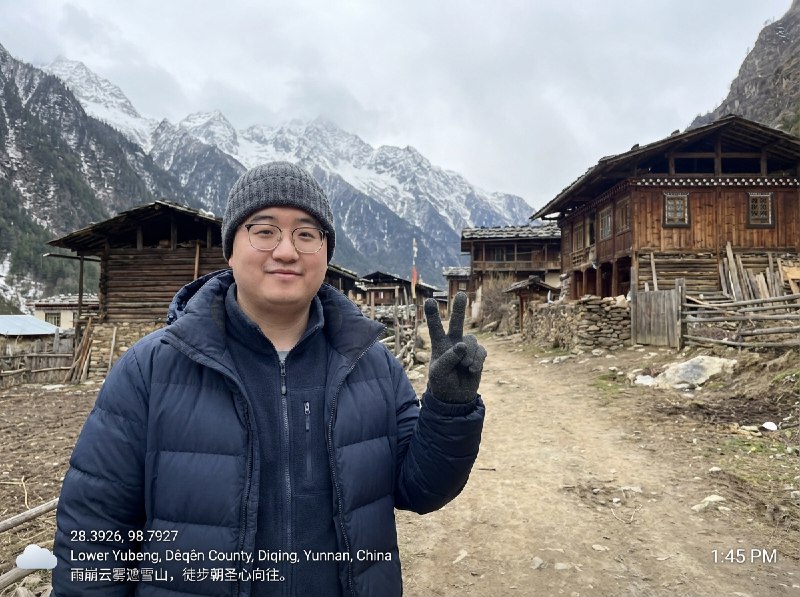
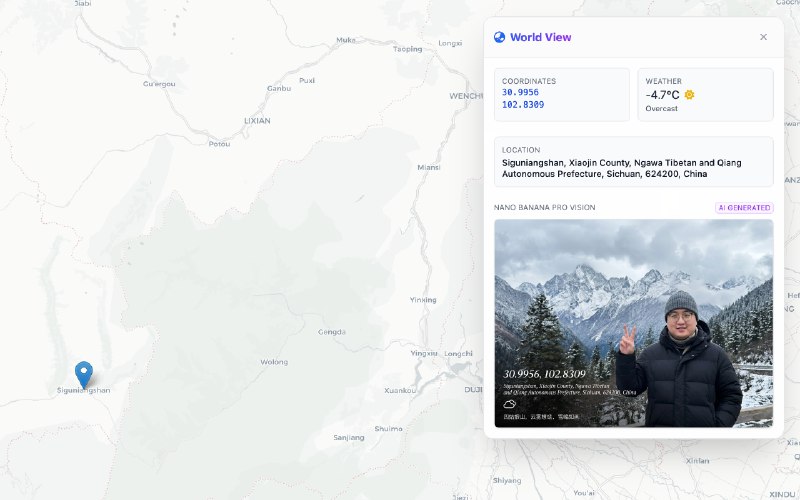
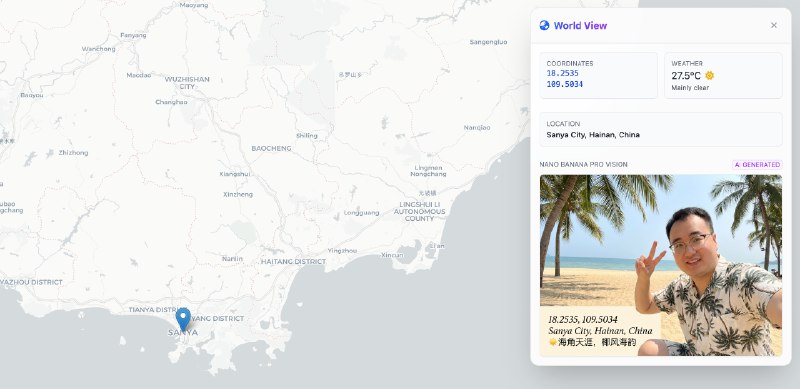
    用 Gemini 3 写了个工具,只需要在地图上选点,然后上传你的人脸照片,就可以生成你在这个地方的打卡照。

    会根据当前位置的天气和时间生成图片,你的衣服也会根据现在的时间以及天气去变化。

    人脸一致性真的太高了,我去。

    ai.studio/apps/drive/1IX2kH8UKwPI6X3khbHsJzPPnGs1e2a12?fullscreenApplet=true

    来玩!需要你自己的 AI Studio API