AI探索指南

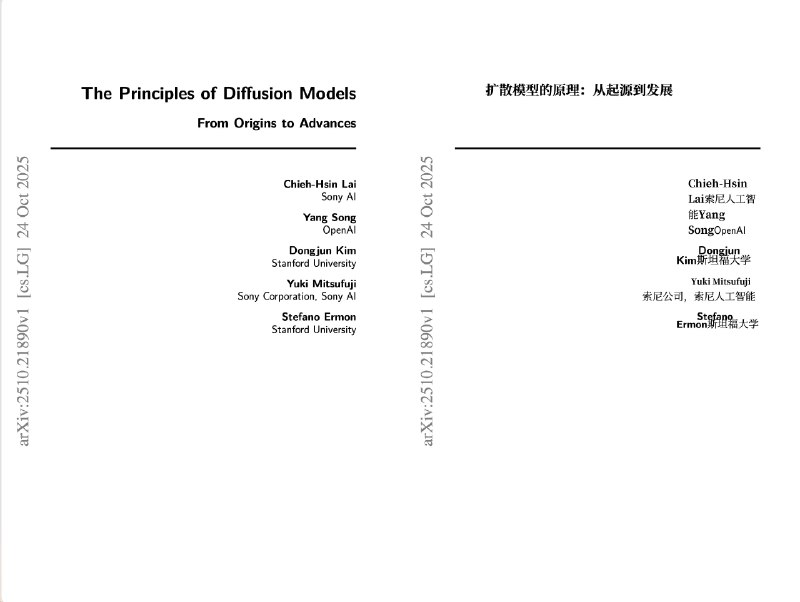
  1. 终于有这么一本读物了,几个 AI 大佬研究员一起出了一个详细讲解扩散模型原理的论文

    终于有这么一本读物了,几个 AI 大佬研究员一起出了一个详细讲解扩散模型原理的论文

    我翻译了一个双语版本,链接放下面了👇#ai创造营##ai画图#

    可以非常全面的理解现在图像和视频模型的基石扩散模型,具体内容有:

    第一章:概览生成模型的定义、重要性与谱系,为统一理解奠基。

    第二章(VAE 视角):以变分推断连接到 DDPM,用潜变量与重构/去噪目标解释训练与采样。

    第三章(EBM/Score 视角):从能量模型到 NCSN/Score SDE,以分数匹配和连续时间 SDE 描述生成动力学。

    第四章:采样即沿时间反向求解 ODE/SDE,用扩散漂移向量场逐步逼近数据分布。

    第五章(NF 视角):从正规化流到 Flow Matching,以可逆变换/流场学习统一“概率随时间运输”的思想。

    第六章:以微积分的换元公式为统一底座,并以“条件化技巧”把难题化为回归,实现稳定可控的训练。

    第八章:在 ODE 框架重审 DDIM、DPM-Solver,澄清与经典数值法的关系并解释快速采样原理。

    第九章:系统化更优数值积分与误差控制,加速迭代采样同时保持保真度与稳定性。

    第十章:提出一致性模型等“流映射”思路,直接学习任意时刻到任意时刻的解映射以少步生成。

    第十一章:扩展一致性轨迹与 Mean Flow,以学习整条轨迹(积分)实现单步或极少步高质量生成。

    双语 PDF:网页链接

  2. 最近的美国裁员潮,背后是两个完全不同的故事

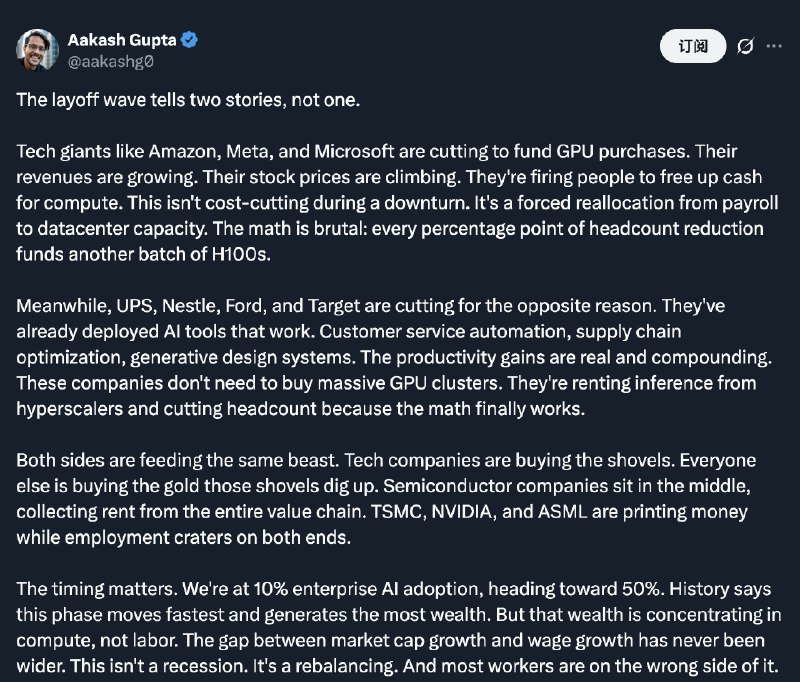
    最近的美国裁员潮,背后是两个完全不同的故事
    亚马逊、Meta、微软这些科技巨头在裁员,但收入在涨,股价在涨。
    他们裁人是为了腾出预算买GPU。
    这不是经济下行时的削减成本,而是把工资预算强行转移到数据中心。
    算法很简单:裁掉1%的人,就能多买一批H100。

    另一边,UPS、雀巢、福特、Target也在裁员,但原因完全相反。
    他们已经用上了真正有效的AI工具:客服自动化、供应链优化、生成式设计系统。生产力提升是真实的,而且在加速。
    这些公司不需要买大规模GPU集群,他们从云服务商那里租推理算力就够了,裁人是因为账算得过来了。

    两边都在喂养同一头野兽。
    科技公司在买铲子,其他公司在买铲子挖出来的金子。
    半导体公司坐在中间,从整个价值链收租。
    台积电、英伟达、ASML在印钞,两端的就业都在崩塌。

    时间点很关键。现在企业AI采用率是10%,正在往50%走。
    历史经验是这个阶段跑得最快,创造的财富最多。
    但这些财富在往算力集中,不是劳动力。
    市值增长和工资增长之间的差距,从来没有这么大过。
    这不是经济衰退,是一次重新平衡。
    大多数打工人在错误的那一边。

    本文翻译自图2,不代表个人观点。

  3. 最近的美国裁员潮,背后是两个完全不同的故事

    最近的美国裁员潮,背后是两个完全不同的故事
    亚马逊、Meta、微软这些科技巨头在裁员,但收入在涨,股价在涨。
    他们裁人是为了腾出预算买GPU。
    这不是经济下行时的削减成本,而是把工资预算强行转移到数据中心。
    算法很简单:裁掉1%的人,就能多买一批H100。

    另一边,UPS、雀巢、福特、Target也在裁员,但原因完全相反。
    他们已经用上了真正有效的AI工具:客服自动化、供应链优化、生成式设计系统。生产力提升是真实的,而且在加速。
    这些公司不需要买大规模GPU集群,他们从云服务商那里租推理算力就够了,裁人是因为账算得过来了。

    两边都在喂养同一头野兽。
    科技公司在买铲子,其他公司在买铲子挖出来的金子。
    半导体公司坐在中间,从整个价值链收租。
    台积电、英伟达、ASML在印钞,两端的就业都在崩塌。

    时间点很关键。现在企业AI采用率是10%,正在往50%走。
    历史经验是这个阶段跑得最快,创造的财富最多。
    但这些财富在往算力集中,不是劳动力。
    市值增长和工资增长之间的差距,从来没有这么大过。
    这不是经济衰退,是一次重新平衡。
    大多数打工人在错误的那一边。

    本文翻译自图2,不代表个人观点。