Deepmind 负责 Nano Banana 的模型研究员录了一期播客(youtube.com/watch?v=H6ZXujE1qBA),非常值得看一下,我整理了一下视频内容:
#ai创造营#新模型与原生图像生成的核心:
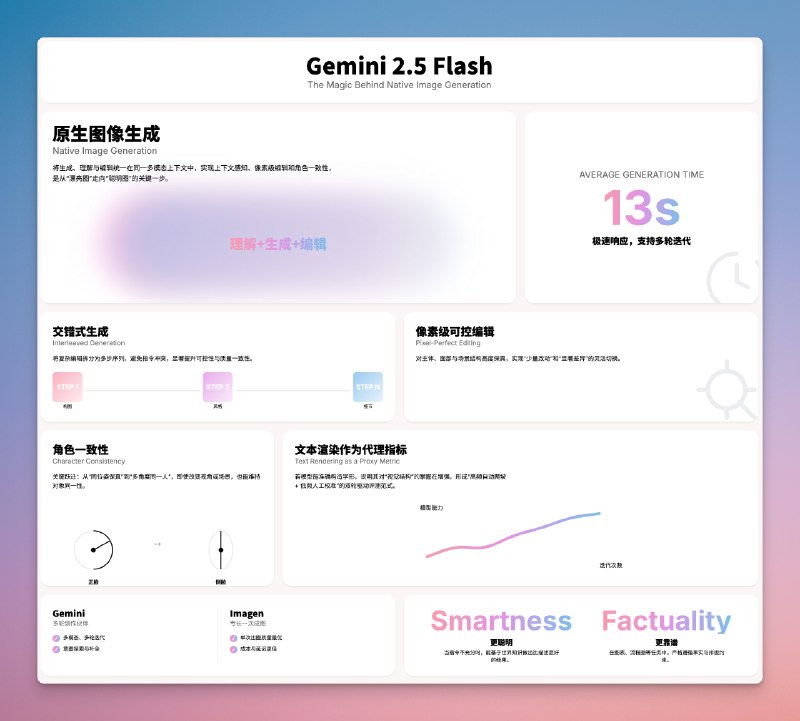
2.5 的核心变化,在于将图像生成、理解与编辑纳入同一多模态上下文里执行。“原生图像生成”意味着模型在一次对话流中逐步产出多张图,并且每一步都“看得到”之前生成的图像与文本,从而可以在风格、构图和语义上保持连续一致。
它更像是一条带状态的生成轨道,每一步的输出既是结果,也是下一步的条件。这一“交错式生成”范式,让复杂编辑自然拆分为多步序列,避免了在“单步巨复杂指令”中丢失细节。
当把“理解”和“生成”并置在同一训练与推理体内会有明显的“正向迁移”:图像理解能力的提升,会帮助生成学习到更多关于真实世界与视觉结构的知识;反之亦然。
文本渲染为何重要:
传统图像/视频模型优化,很依赖人类偏好作为评测信号,这类信号真实但成本高、滞后长、主观性强,难以高频爬坡。
团队因此寻找可以在训练过程中高频追踪的替代指标。文本渲染成为突破口:若模型能在图像中准确构造字形、排布与空间关系,说明其对“视觉结构”的掌握在增强。
这一代理指标的价值在于可持续追踪:无论是架构、数据、训练策略的实验,只要把文本渲染纳入固定监控,就能避免回归,并捕捉到意外有效的改动。
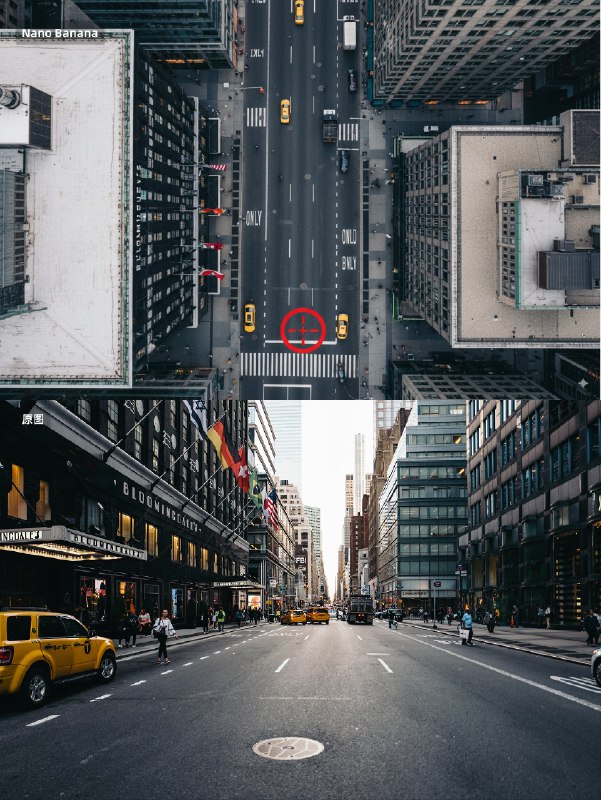
字是一种高度结构化的微任务。当模型学会了在复杂背景中稳定地“写字”,它也更有机会正确处理“平行线条”“规整网格”等同样结构化的视觉课题,让整体画面更可信。
多模态正向迁移:
团队把图像理解与生成称作姐妹。统一训练的目标,是在同一模型里学习多模态的理解/生成能力,并在两者之间产生“正向迁移”。
在生成中辅助理解”的路径:让模型在解题过程中画图打草稿,以更好地把抽象问题视觉化、结构化。一次会话里,模型既能接收用户图片、文本,又能生成中间图像,再用这些中间产物辅助下一步思考,形成自洽的多模态推理链。
展望,从更好看到更聪明与更靠谱:
对未来方向,团队强调两条主线:其一是聪明感”。他们希望当用户指令“不充分、甚至有误”时,模型能“越级发挥”,做出“比用户描述更好”的结果。
其二是事实性/严谨性。在图表、流程图、信息图等“既要好看又要准确”的任务里,模型需要严格遵循事实与排版约束,避免多余文本和逻辑错误,让视觉表达与内容正确双达标。