Huggingface 发布 SmolLM3 3B LLM
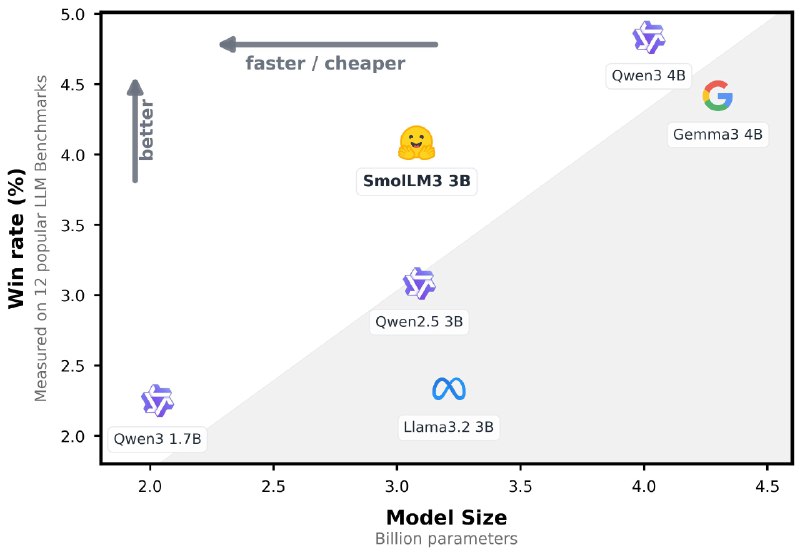
#ai创造营#性能上超越 Llama-3.2-3B 和 Qwen2.5-3B,同时与更大的 4B 模型 Gemma3 持平
除了开源模型本身外,还开源了使用公共数据集和训练框架训练模型的方法
- 3B 模型在 11T Toekn 上训练
- 具备双模式推理的指令模型
-支持 6 种语言的多语言
- 最长支持 128K 上下文
架构与训练细节
采用 Transformer 解码器架构,基于 Llama 并做了多项优化:
Grouped Query Attention (GQA): 替换多头注意力,减少推理时 KV cache 占用。
NoPE: 部分层移除旋转位置编码,提升长上下文表现。
Intra-Document Masking: 保证同一序列不同文档间不可互相注意,提升训练稳定性。
Embedding 层无权重衰减: 参考 OLMo 2,提升训练稳定性。
训练配置:2.36M tokens 全局 batch,序列长度 4096,AdamW 优化器,24 天内用 384 张 H100 GPU 训练。
数据混合与多阶段训练
采用三阶段训练策略,逐步调整 Web、代码、数学数据比例,总计训练 11.2T tokens。
阶段 1:以 Web 数据为主,奠定基础能力。
阶段 2:提升高质量数学和代码数据比例。
阶段 3:进一步提升数学和代码数据占比,加入推理数据。
训练后期进行“mid-training”,分别针对长上下文和推理能力做短期训练。
长上下文与推理能力提升
长上下文扩展:通过两阶段训练将上下文窗口从 4k 扩展到 64k,并用 YARN 技术在推理时支持到 128k。
推理 mid-training:用 35B tokens 的推理数据(如 OpenThoughts3-1.2M、Llama-Nemotron 数据集)提升通用推理能力。
后训练与模型对齐
采用双模式 chat 模板,用户可通过 `/think`(推理)和 `/no_think`(非推理)切换模式。
支持工具调用(XML/Python 工具)。
SFT 阶段用 1.8B tokens 进行监督微调,平衡推理与非推理能力。
用 Anchored Preference Optimization (APO) 进行偏好对齐,提升模型输出质量。