AI探索指南

  1. 仅仅一两年间,AI就带来翻天覆地的变化:从服务「会聊天的人」到渴求「有动机的人」,这看似微妙的转变,却重新定义了人与人的差距

    仅仅一两年间,AI就带来翻天覆地的变化:从服务「会聊天的人」到渴求「有动机的人」,这看似微妙的转变,却重新定义了人与人的差距。

    知识和技能的门槛正在瓦解,取而代之的是能动性的博弈——同样的工具在不同人手中,产生百倍千倍的杠杆差异。这种分化的破坏性,正被严重低估。

    换句话说,那些鼓吹在技术浪潮中无所作为的声音,要么拥有躺平十年的底气,要么还不理解新时代的杠杆意味着什么。例如GPT Image、Google Veo以及Claude Artifacts每一个都如同魔法般的存在。

    我们正处于前所未有的分水岭:能动性将成为稀缺的超级竞争力。

  2. 就一个话题,和 AI 聊了很多问题后,我会在最后再问一句:

    就一个话题,和 AI 聊了很多问题后,我会在最后再问一句:

    回顾以上所有对话:和你对话的这个人的思维有什么特点?用 10 句通俗易懂的话描述特点,清单体。他该怎样更好地与 AI 对话?用 10 句通俗易懂的话给建议,清单体。

    一方面,通过 AI 对我的分析,让我更了解自己;另一方面,可以改进后续和 AI 的对话。

    关于“这个人的思维特点”,我会提取描述得比较准确的,放到《个人自传》中,便于以后和 AI 对话前,让 AI 更深入、更准确地了解我。

    关于“对话的改进建议”,我会放到《AI 对话心得》这份文档中,便于后续更好地和 AI 对话。

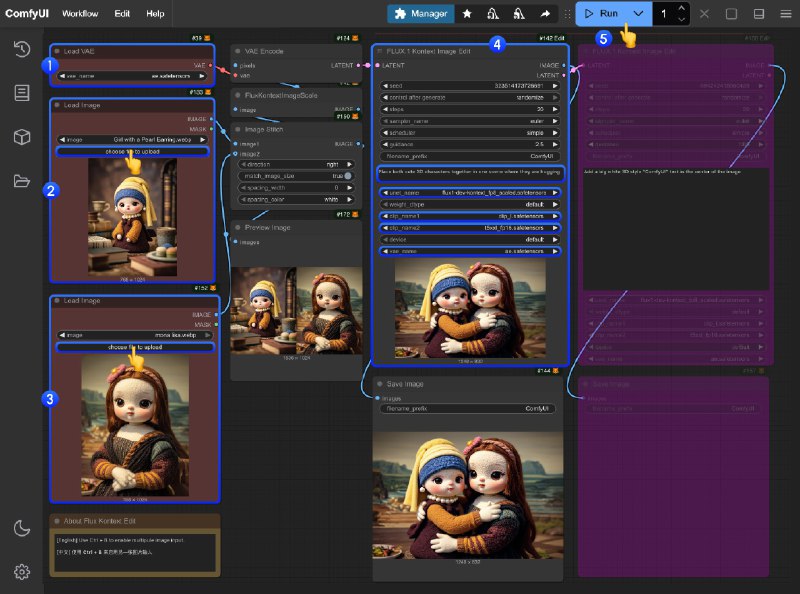
  3. 我去 FLUX Kontext 完全开源了朋友们!

    我去 FLUX Kontext 完全开源了朋友们!
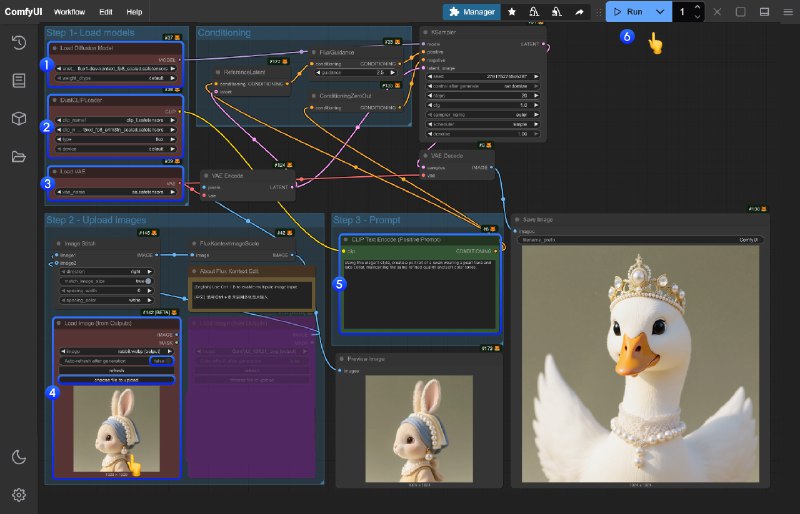
    这是现在商品一致性最简单效果最好的方案,有需求的可以冲了。

    这里有我之前写的用法:https://mp.weixin.qq.com/s/HPBzQqfg4npYAuh9zJHVVw

    模型下载及工作流:https://docs.comfy.org/tutorials/flux/flux-1-kontext-dev

    FLUX.1 Kontext [dev]专注于编辑任务。该模型支持迭代编辑,擅长在多样化场景和环境中保持角色一致性,并允许进行精确的局部和全局修改。

    与英伟达合作,专门针对全新 NVIDIA Blackwell 架构构建了优化版 TensorRT 权重,在保持高质量图像编辑性能的同时,大幅提升推理速度并降低内存占用。

  4. 继上次不少媒体拿大模型做了高考数学题以后,今年的高考全科真题测评结果也出来了,不过这次进行测评的是字节Seed团队,很明显能看出,他们对上次豆包的高考数学成绩是充满意外和惊喜的,也在摩拳擦掌想试试看它在全科试题里会表现如何

    继上次不少媒体拿大模型做了高考数学题以后,今年的高考全科真题测评结果也出来了,不过这次进行测评的是字节Seed团队,很明显能看出,他们对上次豆包的高考数学成绩是充满意外和惊喜的,也在摩拳擦掌想试试看它在全科试题里会表现如何。

    老规矩,这次参战的5个大模型,仍然是市面上各种跑分都名列前茅的选手:Gemini 2.5Pro、DeepSeek R1、Claude 4、OpenAI o3,以及Seed1.6-Thinking。

    高考其实是一种非常典型的测试场景,既能达到测试大模型泛化能力的目的,同时又兼具很高的实用性,也不难想象类似的使用场景,应该可以在教学、科研等方面发挥更大价值。

    这次做的是「山东版」高考全科试卷,分文理科排名,为了确保公平,不仅评测方式完全对齐高考判卷方法,开放题由两名有资深联考判卷经验的高中老师进行评估,而且大模型也没有引入任何提示词工程,所有输入都是高考原题。

    简单来说,这跟一名真实考生做卷子的环境几乎没有区别。

    还是先说结论,大模型的整体能力目前已经能拿到一个相当高的分数,其中位列文、理科头名的豆包和Gemini,分别拿到了文科683和理科655分的成绩——这分数甚至可以冲击一下清北——截取一些测评结果里的关键信息给你们看看:

    - 不出意料的,大模型表现最好的学科是英语,几家测评成绩都很接近,难以拉开差距;

    - 普遍得分最低的学科是化学和生物,不过这跟试题本身有关,这两个学科涉及到的读图题很多,由于这套试题不是官方发布,所以有些图比较模糊,直接造成了大模型的失分;

    - 豆包在语文、英语、物理、地理、历史、政治六门学科里均拿到了最高分,其中文科类目里的地理、历史、政治优势明显,事实证明在不同语种的语境里,大模型的表现可能是天差地别的;

    - 与豆包相反,Gemini的理科表现很强劲,哪怕在图不清楚的情况下,化学、生物仍然拿到了最高分,它与豆包的路线差别很有观察价值;

    - 跟上次高考数学的测评结果略有差异,这次数学学科的榜首是DeepSeek,不过同样与其他大模型差距很小;

    - GPT o3又开始整活,上次它是唯一一个在数学客观题上丢分的大模型,结果这次语文作文直接写跑题了,这导致o3的语文分数成了所有大模型语数英主科15份成绩里,唯一一个没有过百的...

    - 在发现了化学、生物的读图问题后,测试团队找到了一份更高清版本的试卷,并且采用图文交织的方式把这两科重做了一遍,结果发现豆包通过这种方式,两科总分还能再提高30分左右,这就意味着图文同步的全模态推理,可以更大程度激发模型潜力,很值得深究;

    - 目前看来,大模型的视觉方案进步神速,但毕竟视觉的TOKENS消耗要比普通任务高得多,所以它眼下要解决的主要问题,还是如何降本;

    - 除了高考全科真题外,测试团队还进行了另一项印度理工学院JEE Advanced的考试测评,题目全部采用图片输入,总分仍然是Gemini和豆包领先,甚至两个模型的成绩,已经可以进到印度TOP 10了。

    当然,大费周章做这么多测试,倒不是说它是测量大模型能力的唯一标准,比如今年年初AI行业知名的HLE基准刚出现的时候,各大主流模型的得分普遍低于10%,但HLE的开发团队也说了,按照历史规律来看,今年年底这个数字可能就会有50%。

    我的意思是,无论人类如何绞尽脑汁让AI做题,把题目通关也都是假以时日的问题,但这不代表做题成绩就没有意义了,重要的是不断精进学习的过程,也是探索AI究竟能多大程度上为人类所用的必要步骤。

    已经开始期待明年高考,AI会给我们一番怎样的景象了。

  5. 从简单记忆功能做起,逐步优化

    AI探索指南
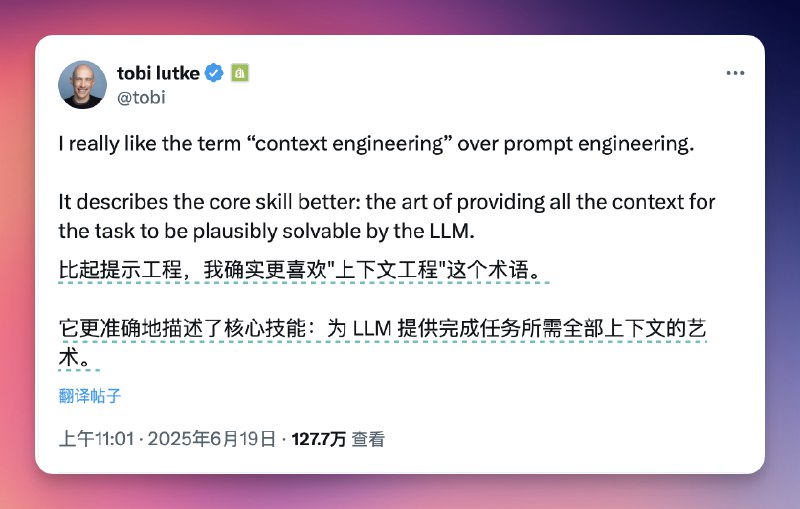
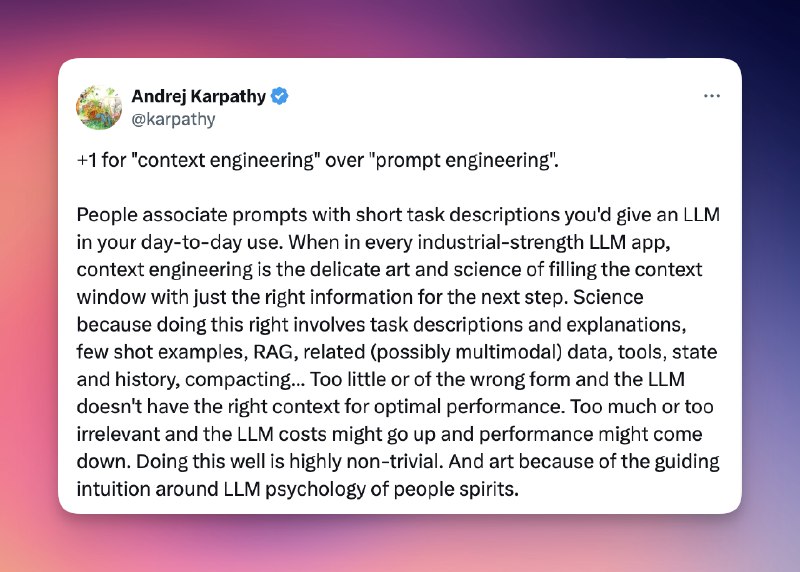
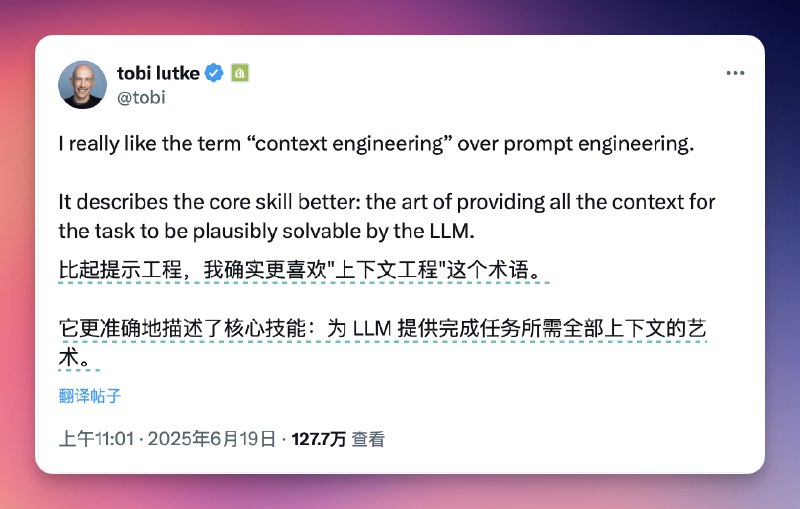
    聊一下最近圈子热议的话题 Shopify CEO 和Andrej Karpathy 都同意的观点:提示工程的名称是否应该改为上下文工程 主要包括: - 各路大神的观点 - 为什么上下文工程如此重要 - 上下文工程的三大策略 - 其他实践经验与建议 完整的文章在这里看,这里发一下文章的总结:https://mp.weixin.qq.com/s/wWR-1lLMhJ9OTj62JXaM_g 近期AI圈热议“提示工程”是否应更名为“上下文工程”,因为后者更准确地描述了为大模型(LLM)提供任务所需全部信息的工作。…
    从简单记忆功能做起,逐步优化。
    多Agent方案适用于可并行化任务,但需注意协调难题。

    结论
    上下文管理是构建健壮AI Agent的核心,需在性能、成本和准确性间平衡。
    上下文工程是一门平衡的艺术,良好的语境和清晰表达需求是获得优质LLM输出的关键。

  6. 聊一下最近圈子热议的话题

    聊一下最近圈子热议的话题

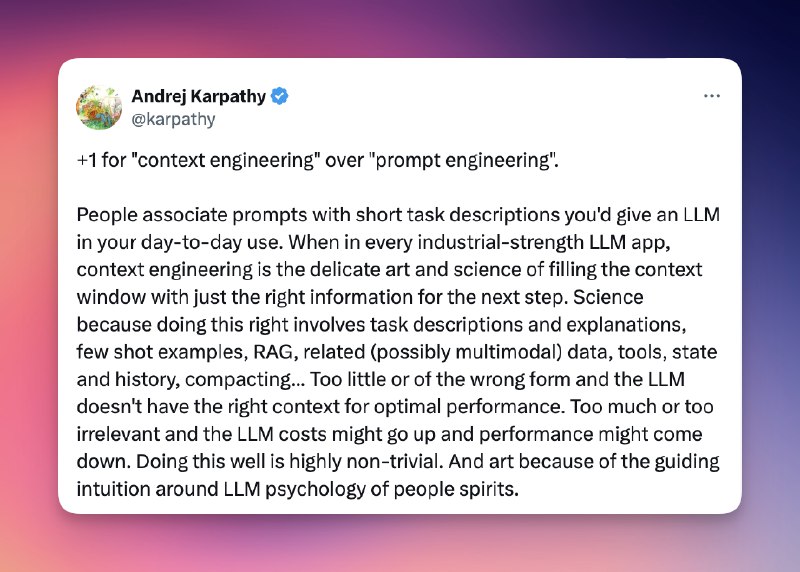
    Shopify CEO 和Andrej Karpathy 都同意的观点:提示工程的名称是否应该改为上下文工程

    主要包括:
    - 各路大神的观点
    - 为什么上下文工程如此重要
    - 上下文工程的三大策略
    - 其他实践经验与建议

    完整的文章在这里看,这里发一下文章的总结:https://mp.weixin.qq.com/s/wWR-1lLMhJ9OTj62JXaM_g

    近期AI圈热议“提示工程”是否应更名为“上下文工程”,因为后者更准确地描述了为大模型(LLM)提供任务所需全部信息的工作。
    Shopify CEO Tobi Lutke 和 Andrej Karpathy 等人认为,“上下文工程”更能体现工业级LLM应用中对上下文的精细管理和填充。
    上下文工程不仅仅是写好提示词,还包括任务描述、样本、RAG(检索增强生成)、多模态数据、工具、状态、历史和信息压缩等。

    上下文工程的重要性

    Cognition 和 Anthropic 等公司在多Agent系统中强调上下文管理的重要性。
    不充分的上下文会导致Agent工作不一致,过长或不相关的上下文会增加成本、降低性能。
    多轮对话中,指令遵循性下降,优化上下文长度和准确性尤为关键。

    上下文工程的三大策略

    1. 压缩(Compression)
    目标:每轮对话只保留最有价值的Token。
    方法:上下文摘要(如Claude Code自动压缩、Cognition用微调模型压缩)。
    难点:高质量摘要难以实现。

    2. 持久化(Persistence)
    目标:构建可长期存储、保存和检索上下文的系统。
    存储方式:文件(如CLAUDE .md)、嵌入式文档、知识图谱等。
    保存策略:用户手动或Agent自动生成/更新记忆(如Reflexion机制)。
    检索方式:直接加载或基于嵌入向量/图检索,需防止检索出错导致“跑题”。

    3. 隔离(Isolation)
    目标:在不同Agent或环境间划分上下文。
    方法:结构化上下文模式(如Pydantic模型)、多Agent分散上下文、环境隔离(如HuggingFace的沙盒环境)。
    多Agent系统可提升性能,但也带来Token消耗和协调难题,适合可并行化任务。

    实践经验与建议
    工具先行,优先关注数据和Token追踪。
    明确Agent状态,梳理运行时所需信息。
    在工具边界处进行上下文压缩。

  7. 上下文管理是构建健壮AI Agent的核心,需在性能、成本和准确性间平衡

    AI探索指南
    聊一下最近圈子热议的话题#ai创造营# Shopify CEO 和Andrej Karpathy 都同意的观点:提示工程的名称是否应该改为上下文工程 主要包括: - 各路大神的观点 - 为什么上下文工程如此重要 - 上下文工程的三大策略 - 其他实践经验与建议 这里发一下文章的总结 近期AI圈热议“提示工程”是否应更名为“上下文工程”,因为后者更准确地描述了为大模型(LLM)提供任务所需全部信息的工作。 Shopify CEO Tobi Lutke 和 Andrej Karpathy 等人认为,“…
    上下文管理是构建健壮AI Agent的核心,需在性能、成本和准确性间平衡。
    上下文工程是一门平衡的艺术,良好的语境和清晰表达需求是获得优质LLM输出的关键。

  8. 聊一下最近圈子热议的话题#ai创造营#

    聊一下最近圈子热议的话题#ai创造营#

    Shopify CEO 和Andrej Karpathy 都同意的观点:提示工程的名称是否应该改为上下文工程

    主要包括:
    - 各路大神的观点
    - 为什么上下文工程如此重要
    - 上下文工程的三大策略
    - 其他实践经验与建议

    这里发一下文章的总结

    近期AI圈热议“提示工程”是否应更名为“上下文工程”,因为后者更准确地描述了为大模型(LLM)提供任务所需全部信息的工作。
    Shopify CEO Tobi Lutke 和 Andrej Karpathy 等人认为,“上下文工程”更能体现工业级LLM应用中对上下文的精细管理和填充。
    上下文工程不仅仅是写好提示词,还包括任务描述、样本、RAG(检索增强生成)、多模态数据、工具、状态、历史和信息压缩等。

    上下文工程的重要性

    Cognition 和 Anthropic 等公司在多Agent系统中强调上下文管理的重要性。
    不充分的上下文会导致Agent工作不一致,过长或不相关的上下文会增加成本、降低性能。
    多轮对话中,指令遵循性下降,优化上下文长度和准确性尤为关键。

    上下文工程的三大策略

    1. 压缩(Compression)
    目标:每轮对话只保留最有价值的Token。
    方法:上下文摘要(如Claude Code自动压缩、Cognition用微调模型压缩)。
    难点:高质量摘要难以实现。

    2. 持久化(Persistence)
    目标:构建可长期存储、保存和检索上下文的系统。
    存储方式:文件(如CLAUDE .md)、嵌入式文档、知识图谱等。
    保存策略:用户手动或Agent自动生成/更新记忆(如Reflexion机制)。
    检索方式:直接加载或基于嵌入向量/图检索,需防止检索出错导致“跑题”。

    3. 隔离(Isolation)
    目标:在不同Agent或环境间划分上下文。
    方法:结构化上下文模式(如Pydantic模型)、多Agent分散上下文、环境隔离(如HuggingFace的沙盒环境)。
    多Agent系统可提升性能,但也带来Token消耗和协调难题,适合可并行化任务。

    实践经验与建议
    工具先行,优先关注数据和Token追踪。
    明确Agent状态,梳理运行时所需信息。
    在工具边界处进行上下文压缩。
    从简单记忆功能做起,逐步优化。
    多Agent方案适用于可并行化任务,但需注意协调难题。

    结论

  9. Anthropic 这个 Claude Artifacts 升级太牛皮了!

    Anthropic 这个 Claude Artifacts 升级太牛皮了!

    现在构建 AI 应用变得前所未有的简单

    只要跟 Claude 说“帮我创建一个 AI 应用程序”,后面跟上提示词

    就会帮你创建可以调用 Claude 的网页,而且其他人用的时候用的他们自己的账号额度

    我用这个功能创建创建了一个分享图生成工具。
    用的我原来那个 Bento Grid 风格 提示词。
    现在每个人都可以用这个网页快速生成对应文案的分享图片了!

    这里尝试,需要 Claude 账号:claude.ai/public/artifacts/f6cda2d3-2ff3-41ff-a8c1-3d19b8e18bb7